HELLO LLM · 免费学习 · 非商业使用
手写小模型,
看懂大模型。
从一个能手算的神经元开始,
亲手接出能训练、能生成文字的小语言模型。
零基础可入门 · 20 讲 · 无需 GPU
从文字,到下一个字TinyLM
早上,小丁喜欢
把新字接回输入,再算一次
让原理,在手上走一遍
改数、写代码,再亲手训练一个模型。
视频讲解
从原理到源码,再到运行结果。
一步步,把模型造出来
沿着同一个项目学习,每个阶段都有可核对的成果。
先从这里开始
认识这门课,再给成品模型出两道题。
让数值网络学起来
从一个输出开始,看到错误怎样改变参数。
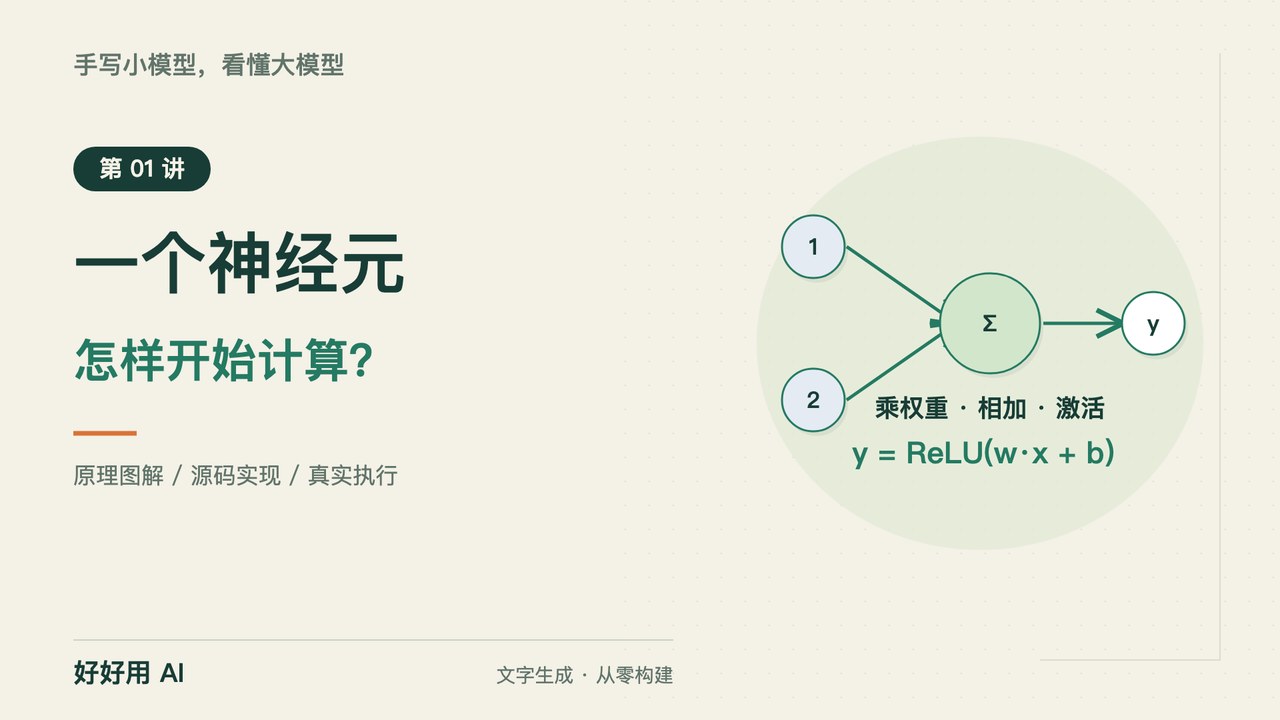
- 01神经元:模型接着写字,底下先算什么?解释输入、参数和激活各自的作用。
- 02向量与矩阵:算两个数,要复制两遍代码吗?按轴解释输入、参数和输出的形状。
- 03非线性:四行规则,为什么乘加函数做不到?解释叠层与增加非线性的区别。
- 04梯度:方向对了,为什么也会越改越差?区分梯度给出的局部方向与实际更新步长。
- 05反向传播:9个参数,难道要逐个试?手算一条反向路径,解释分支合流与统一更新。
- 06训练循环:更新500次,四条预测会怎样?写出一轮训练,解释清梯度并识别广播错题。
阶段目标:完成第一次学习闭环
把文字接进来
把文字变成输入、概率和训练题。
- 07Embedding:文字怎样变成网络的输入?区分字符编号、词向量与张量三根轴。
- 08Softmax:分数怎样变成下一字的概率?解释候选分数、相对竞争与归一化。
- 09训练目标:一句话怎样变成可学习的题?构造错位标签并解释有效位置的平均损失。
阶段目标:训练第一个字符预测模型
读取前文,组装模型
补上上下文和顺序,把组件接成完整网络。
- 10注意力:预测下一字,怎样读到前文?算清一行注意力,并区分比例与读出内容。
- 11因果掩码:并行训练为什么不算偷看答案?解释因果可见性与掩码的正确位置。
- 12多头注意力:各个头分别读向哪里?解释分头、各头独立配比与拼回,识别同形状的错轴。
- 13RoPE:模型怎样知道先后顺序?把二维旋转公式接到相对位置与Q/K点积。
- 14SwiGLU:读完前文以后,还要怎么算?解释门控的输入依赖与逐位置加工。
- 15残差与RMSNorm:为什么留一条原路?把分头、旋转与因果汇总封成注意力组件,再接残差与Pre-Norm模型块。
- 16完整模型:跟着“欢”这个字走一遍组装完整模型,定位表示、参数和词表分数。
阶段目标:看清完整模型的一次前向计算
预训练、生成与微调
让同一个模型学会续写,再尝试回答问题。
- 17预训练:训练题熟了,新题为什么更差?完成预训练,并依据数据差异解释评估变化。
- 18生成:一句话究竟做了几次选择?写出生成循环并解释随机选择与停止条件。
- 19监督微调:会续写,为何还不会回答?构造答案监督,并通过三方法、三种子的固定对照诊断微调取舍。
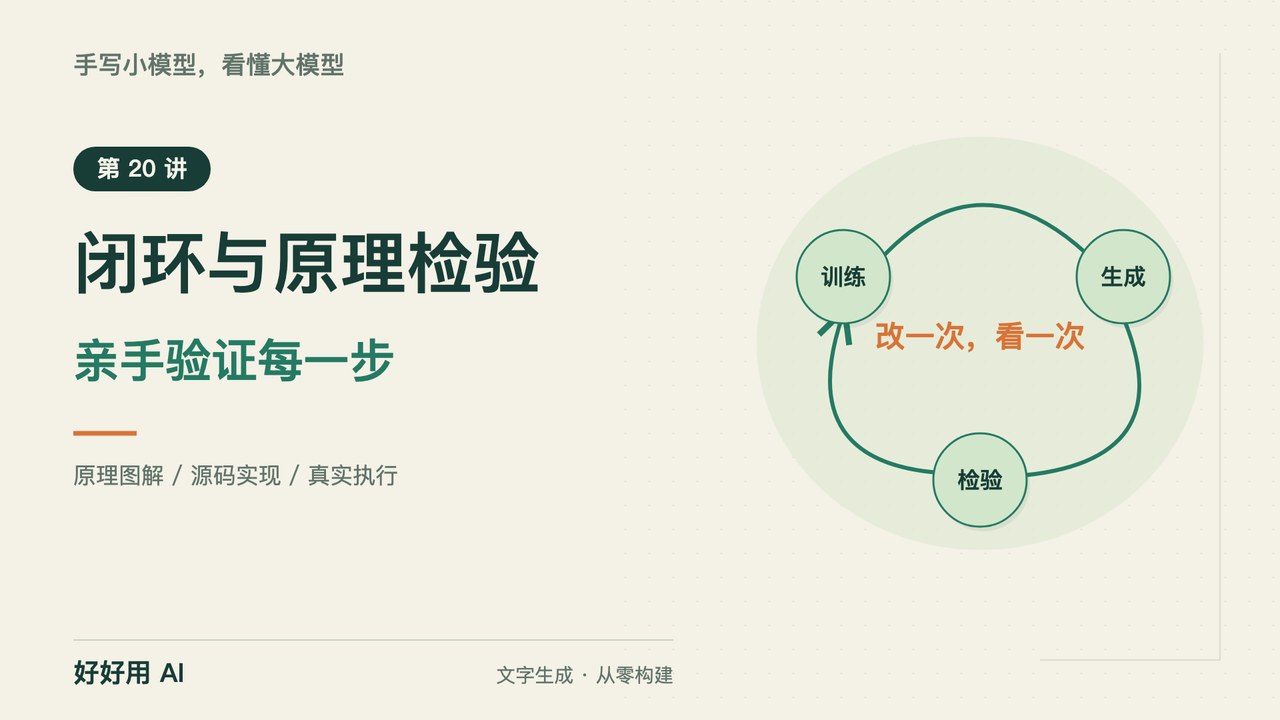
- 20全流程:把预训练、微调和生成串起来独立完成数据、词表、模型、训练和重载的迁移实验,并解释成功与失败。
阶段目标:复现训练,并用独立数据检验理解
走完 20 讲之后
回看起点,梳理你已经能解释的模型行为。
下载电子书
PDF 适合打印,EPUB 适合手机和阅读器。
中文 · v0.1.0-rc.1